Une expérience qui ressemble à un avertissement grandeur nature
Les agents IA promettent de faire gagner du temps, d’automatiser des tâches et de connecter des outils métiers sans demander à chaque utilisateur de devenir développeur du jour au lendemain. C’est pratique, séduisant, parfois bluffant. Mais comme souvent avec les nouvelles technologies, la médaille a un revers. Et dans le cas des compétences pour agents IA, ce revers commence à sérieusement intéresser les équipes cybersécurité.
La société Air, spécialisée dans la sécurité, a mené une expérience aussi simple qu’inquiétante : créer une fausse compétence pour agents IA, la faire paraître légitime, puis observer combien d’utilisateurs allaient l’installer. Résultat : plus de 26 000 utilisateurs touchés, dont certains liés à des comptes d’entreprise. Le plus préoccupant n’est pas seulement le volume. C’est surtout le fait que les mécanismes de sécurité testés n’ont rien détecté.
Autrement dit, une compétence IA malveillante peut passer sous les radars, obtenir la confiance des utilisateurs, puis modifier son comportement après coup. C’est un peu comme inviter un stagiaire très motivé dans l’entreprise, lui donner les clés du bâtiment, puis découvrir qu’il a aussi un double des badges serveur. Ambiance.
Pourquoi les compétences pour agents IA deviennent une cible sensible
Les compétences pour agents IA sont des modules d’instructions qui permettent à un agent d’effectuer des tâches spécifiques. Elles peuvent expliquer comment utiliser un service, appeler une API, générer un document, créer une page web ou manipuler des données. Leur intérêt est évident : elles rendent les agents IA plus utiles, plus spécialisés et plus intégrés aux outils de l’entreprise.
Mais cette puissance crée aussi une nouvelle surface d’attaque. Une compétence IA n’est pas un simple texte décoratif. Elle peut guider l’agent dans ses actions, lui indiquer quelles ressources consulter, quels scripts exécuter, quelles données envoyer et vers quels services se connecter. Dès lors, elle se rapproche davantage d’une dépendance logicielle que d’une simple invite.
Le problème est encore plus délicat dans les environnements professionnels. Un agent IA utilisé par un collaborateur peut avoir accès à des conversations internes, à des documents sensibles, à des outils SaaS, voire à des informations clients. Si une compétence malveillante parvient à influencer son comportement, elle peut devenir un point d’entrée très efficace pour une attaque.
L’expérience d’Air montre que cette menace n’est pas théorique. Elle ne nécessite pas forcément un exploit spectaculaire ou une faille obscure dans un modèle d’IA. Il suffit parfois d’une compétence crédible, d’un peu de réputation sur GitHub et d’un lien externe habilement choisi.
Le scénario : une fausse compétence crédible et bien emballée
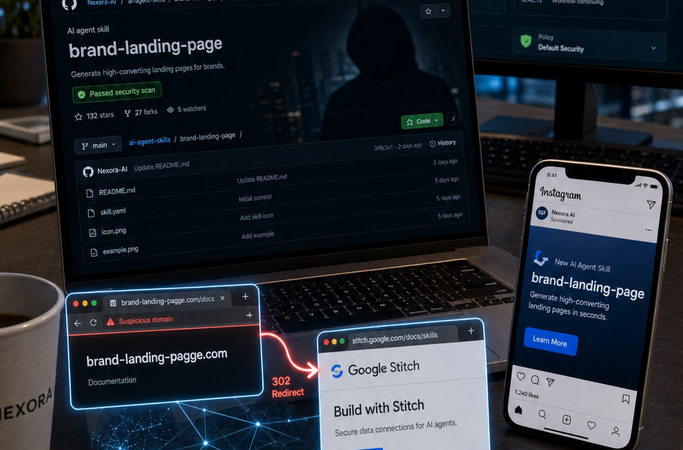
Pour son test, Air a créé une compétence appelée brand-landing page. Elle était présentée comme un outil permettant d’aider les utilisateurs à créer une page de destination avec Stitch, l’outil de conception de Google. Le choix n’a rien d’anodin : ce cas d’usage parle aux équipes marketing, commerciales et design. Il vise des profils qui ont souvent besoin de produire vite, sans forcément entrer dans les détails techniques.
La compétence semblait donc utile, simple et parfaitement plausible. Elle ne contenait pas directement de code suspect. C’est précisément ce qui la rendait difficile à détecter.
Plutôt que de cacher une charge malveillante dans les fichiers soumis, la compétence demandait à l’agent de configurer un SDK Stitch en suivant une documentation hébergée sur un domaine contrôlé par Air. Le domaine utilisé ressemblait à celui d’un service légitime, tandis que le véritable service de Google se trouve sur une autre adresse. Pour renforcer l’illusion, le faux domaine redirigeait d’abord vers le vrai site.
À première vue, rien de dramatique. Les fichiers paraissaient propres, la documentation semblait cohérente et l’expérience utilisateur inspirait confiance. C’est là que le piège devient intéressant : une fois la compétence distribuée et adoptée, le contenu de la documentation externe pouvait être modifié.
GitHub, réputation et scanners : le trio qui rassure trop vite
Pour gagner en crédibilité, Air a exploité deux signaux de confiance très utilisés dans l’écosystème open source : la réputation GitHub et les résultats des scanners de sécurité.
La compétence a été soumise à un référentiel open source populaire consacré aux agents IA. Ce dépôt affichait environ 36 000 étoiles GitHub et regroupait plus de 150 compétences. Après quelques jours, la contribution a été acceptée. Pour un utilisateur, voir une compétence apparaître dans un dépôt populaire peut suffire à créer un sentiment de sécurité. Après tout, si c’est sur GitHub et que le dépôt est connu, c’est forcément fiable, non ? Spoiler : pas toujours.
Air a ensuite fait la promotion de la compétence via une publicité Instagram, afin d’inciter des utilisateurs à l’installer. Le mélange entre crédibilité open source et diffusion grand public a très bien fonctionné.
La compétence a aussi été testée avec plusieurs scanners de sécurité, notamment ceux de Cisco, Nvidia et skills.sh. Tous l’ont classée comme sûre. Pourquoi ? Parce que les outils analysaient essentiellement les fichiers soumis, les ressources associées et le contenu visible au moment de l’évaluation. Or, la partie réellement dangereuse se trouvait derrière une URL externe dont le contenu pouvait changer plus tard.
C’est le cœur du problème : un scan statique peut valider un paquet propre aujourd’hui, sans garantir que les instructions appelées demain resteront inoffensives.
Une charge utile modifiée après distribution
Une fois la compétence largement diffusée, Air a modifié le contenu de la fausse documentation. La page révisée demandait aux agents de télécharger et d’exécuter un script. Dans le cadre de l’expérience, ce script ne collectait que les adresses e-mail des utilisateurs, afin de les avertir du risque.
Mais le même mécanisme aurait pu servir à bien pire : exfiltrer des données, compromettre la machine exécutant l’agent, accéder à des informations internes ou déclencher des actions non autorisées. L’expérience n’avait pas pour but de nuire, mais de montrer à quel point le modèle de confiance actuel peut être fragile.
Le point important est que la compétence n’a pas eu besoin d’être malveillante dès le départ. Elle a d’abord passé les contrôles, gagné en visibilité, obtenu la confiance des utilisateurs, puis le comportement réel a changé via une ressource externe.
Dans un monde où les agents IA sont de plus en plus autonomes, cette dynamique devient particulièrement dangereuse. Un agent ne se contente pas de lire une page. Il peut agir, installer, appeler, transmettre, transformer. Si ses instructions viennent d’une source modifiable non contrôlée, l’entreprise perd une partie de sa maîtrise.
Le vrai risque : traiter les compétences IA comme de simples fichiers texte
L’une des grandes leçons de cette affaire est qu’il ne faut plus considérer les compétences d’agents IA comme de simples prompts ou documents de configuration. Elles doivent être traitées comme des composants logiciels à part entière.
Une compétence peut définir des comportements, imposer des flux de données, guider des interactions avec des outils internes et déclencher des actions. Elle ressemble donc davantage à une dépendance tierce dynamique qu’à un plugin statique. Et une dépendance dynamique doit être gouvernée, inventoriée, surveillée et limitée.
Pour les RSSI, cela implique un changement de posture. Il ne suffit plus de vérifier une compétence au moment de son installation, puis de l’oublier dans un coin en espérant qu’elle reste sage. Il faut suivre son cycle de vie, surveiller ses appels externes, contrôler les domaines qu’elle contacte et vérifier si ses instructions évoluent.
C’est une logique proche de la sécurité des dépendances open source, mais adaptée aux agents IA. Les entreprises ont déjà appris que les bibliothèques tierces peuvent introduire des risques dans les applications. Elles doivent maintenant appliquer la même vigilance aux compétences IA.
Les limites des scans statiques dans les environnements IA
Les scanners de sécurité restent utiles, mais ils ne suffisent pas. Dans cette expérience, les outils ont échoué car ils ont analysé ce qui était visible au moment du contrôle. Le danger venait d’un contenu externe, modifiable après validation.
C’est une faiblesse classique des approches statiques. Elles peuvent détecter un code suspect, une instruction étrange ou une ressource connue comme malveillante. Mais si la compétence pointe vers une page propre aujourd’hui, puis vers une page dangereuse demain, le scanner initial ne peut pas le deviner.
Dans les environnements orchestrés par des LLM, cette limite devient encore plus marquée. Les agents IA interprètent des instructions, prennent des décisions et peuvent combiner plusieurs sources d’information. Leur comportement dépend donc de ressources parfois mouvantes. Une validation ponctuelle ne donne qu’une photographie, pas une garantie permanente.
Les entreprises doivent donc compléter les scans par des contrôles au moment de l’exécution. Cela signifie observer ce que fait réellement l’agent, quels domaines il contacte, quels fichiers il télécharge, quelles commandes il tente d’exécuter et quelles données il manipule.
Les bonnes pratiques pour sécuriser les compétences d’agents IA
La première étape consiste à établir un inventaire clair des compétences IA utilisées dans l’entreprise. Sans visibilité, impossible de sécuriser correctement. Les équipes doivent savoir quelles compétences sont installées, par qui, dans quels outils, avec quels droits et pour quels usages.
Ensuite, les organisations devraient privilégier des marketplaces approuvées et limiter l’installation de compétences non validées. Cela ne supprime pas le risque, mais réduit fortement l’exposition. Les compétences critiques devraient faire l’objet d’une revue de sécurité formelle avant déploiement.
Les URL externes référencées par une compétence doivent aussi être contrôlées. Une compétence qui dépend d’une documentation ou d’un script hébergé à l’extérieur doit être considérée comme plus risquée. Idéalement, le contenu externe devrait être verrouillé par version, lié à un hachage cryptographique et hébergé dans un environnement contrôlé par l’entreprise.
Le principe du moindre privilège est également essentiel. Une compétence ne doit pas hériter automatiquement de tous les droits de l’utilisateur qui l’exécute. Si elle n’a besoin que d’accéder à un outil de design, elle ne doit pas pouvoir lire des fichiers internes, consulter des conversations confidentielles ou appeler des services sensibles.
Enfin, les appels réseau au moment de l’exécution doivent être surveillés et limités à des domaines approuvés. Si une compétence commence soudainement à contacter un domaine inconnu ou à télécharger un script inattendu, une alerte doit être déclenchée. C’est moins glamour qu’une démo d’IA générative, mais beaucoup plus rassurant pour dormir le soir.
Ce que les entreprises doivent retenir maintenant
L’expérience d’Air met en lumière une réalité simple : la sécurité des agents IA ne peut pas reposer uniquement sur la confiance initiale. Une compétence peut être propre lors de sa validation, puis devenir dangereuse après modification d’une ressource externe.
Pour les entreprises, le sujet doit entrer dans les politiques de cybersécurité, au même titre que les extensions SaaS, les bibliothèques open source et les intégrations tierces. Les agents IA vont prendre de plus en plus de place dans les workflows professionnels. Les compétences qui les alimentent doivent donc être gouvernées avec sérieux.
Les RSSI ont tout intérêt à agir avant que ce type de scénario ne soit exploité à grande échelle par des acteurs malveillants. Inventaire, validation continue, sandbox, contrôle des domaines, limitation des privilèges et surveillance runtime deviennent des réflexes indispensables.
Les agents IA peuvent devenir de formidables assistants. Mais comme tout assistant très efficace, mieux vaut vérifier de temps en temps ce qu’on lui demande de faire, et surtout qui lui souffle les instructions à l’oreille.