Une nouvelle génération d’OCR : lire un document, pas juste du texte
Numériser un document, ce n’est pas simplement transformer une photo en phrases bien propres. Un vrai document papier, c’est un écosystème : titres, encadrés, tableaux, colonnes, signatures, tampons, et parfois cette note au stylo qui ressemble à une incantation médiévale.
Avec OCR 4, dévoilé le 23 juin 2026, Mistral annonce une IA de reconnaissance optique de caractères capable d’aller plus loin que la transcription. L’objectif affiché est clair : restituer la structure complète d’une page et comprendre l’organisation du contenu.
En pratique, cela signifie que l’outil ne se contente pas de dire “voici le texte”, mais cherche à répondre à “voici le texte, voici où il se trouve, voici ce que c’est, et voici mon niveau de certitude”. Et dans un monde rempli de PDF scannés de travers, c’est presque un super pouvoir.
Ce que Mistral OCR 4 promet de faire mieux
Le point fort annoncé d’OCR 4, c’est la capacité à localiser et catégoriser les éléments d’un document.
Une page découpée en blocs intelligents
D’après les informations relayées, OCR 4 identifie les zones de la page via des cadres de détection, puis classe chaque bloc par type :
- titre
- paragraphe
- tableau
- équation
- signature
- note manuscrite
Ce n’est pas un détail cosmétique. Pour automatiser derrière, il faut savoir si on lit une ligne de texte ou une cellule de tableau, si une “signature” est un nom ou un gribouillis, et si le chiffre “8” n’est pas en réalité un “B” de quelqu’un qui écrit comme un médecin pressé.
Un score de confiance mot par mot
Autre élément important : un score de confiance serait attribué à chaque mot. C’est exactement le genre de fonctionnalité qui évite de faire confiance aveuglément à la machine.
En clair : l’IA peut dire “je pense que c’est écrit 12 548, mais je ne mettrais pas ma main au feu”. Et ça permet de bâtir des workflows où les zones incertaines passent en validation humaine.
170 langues prises en charge, y compris les moins “servies”
Mistral met en avant un support de 170 langues, dont des langues peu documentées et souvent mal reconnues par les outils classiques.
Pourquoi c’est un gros sujet ? Parce que l’OCR, dans le monde réel, se heurte à tout ce qui n’est pas un document propre en anglais, imprimé en police standard.
Des usages évidents dans les corpus historiques
Dès qu’on parle d’archives, on parle de :
- vieux documents d’administration
- registres
- correspondances
- journaux
- documents multilingues
Or ces corpus sont précisément ceux qui posent problème : papier jauni, encre qui bave, orthographe d’époque, mise en page irrégulière, et manuscrit parfois… créatif.
OCR 4 vise donc un terrain où la valeur est énorme : rendre recherchable et exploitable ce qui est aujourd’hui enfermé dans des images.
Manuscrits : l’étape qui fait transpirer l’OCR
Lire du texte imprimé, même dans plusieurs langues, c’est déjà bien. Lire du manuscrit, c’est un autre sport.
Les notes à la main dans la marge, les formulaires remplis au stylo, les signatures, les mentions “vu et approuvé” écrites en diagonale… ce sont des cas d’usage hyper fréquents, surtout dans les organisations qui vivent encore entourées de papier.
Et non, le papier n’a pas disparu. Il se cache. Comme les câbles derrière la télé.
L’angle concret : numériser des montagnes d’archives (coucou l’administration)
Derrière l’annonce, l’enjeu est très pragmatique : industrialiser la numérisation.
Les exemples d’usage évoqués tournent autour de besoins très “terrain” :
- transformer des factures en champs structurés
- extraire le texte de rapports techniques
- convertir des documents scannés en données exploitables
- numériser des archives d’entreprise
Et forcément, on pense à toutes les institutions qui ont des kilomètres de dossiers. L’idée n’est pas de faire une démo spectaculaire avec une page parfaite, mais de tenir la charge sur des volumes massifs et des documents imparfaits.
Important : comprendre, pas décider
Mistral précise que son modèle est conçu pour comprendre des documents, pas pour prendre des décisions à fort enjeu.
Le modèle écarte explicitement des cas comme :
- diagnostic médical
- jugement juridique
- décisions financières critiques
Ce positionnement est logique : OCR 4 est un moteur de lecture et d’extraction. Il peut accélérer, trier, indexer, préparer. Mais la validation finale reste un sujet d’organisation, de conformité, et souvent… de bon sens.
Face aux modèles chinois et aux géants américains : la bataille de l’OCR s’intensifie
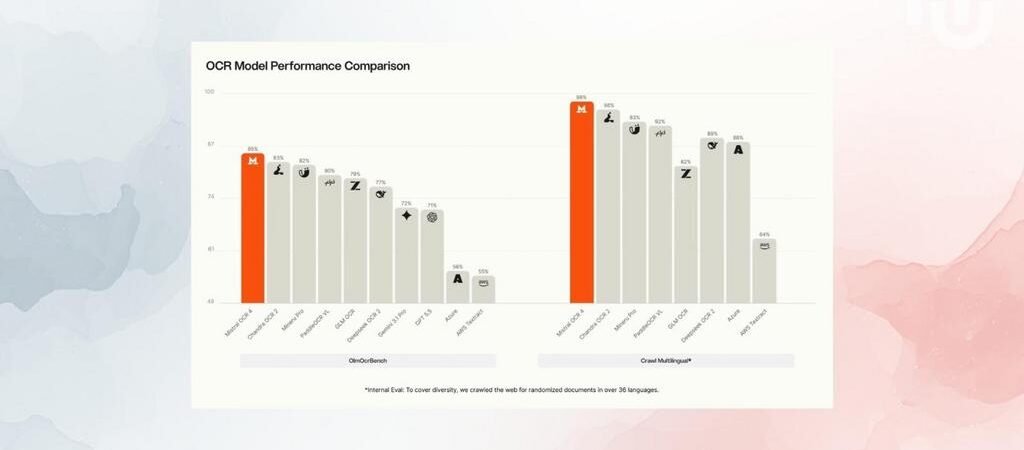
Le marché de l’OCR a bougé très vite en 2025 et 2026, avec une vague de modèles spécialisés, souvent open source et souvent chinois : DeepSeek-OCR, PaddleOCR-VL (Baidu), Qwen3-VL (Alibaba). Beaucoup performent très haut sur des benchmarks du secteur.
En parallèle, les gros acteurs américains restent présents avec des solutions bien intégrées : Google Document AI, Microsoft Azure, et des modèles de vision plus généralistes.
L’argument performance : préféré dans 72 % des cas
Mistral met en avant une évaluation réalisée par des annotateurs indépendants : sur plus de 600 documents réels, dans plus de 12 langues, OCR 4 aurait été préféré dans 72 % des cas en moyenne, face aux concurrents testés.
Ce chiffre, pris seul, ne dit pas tout (tout dépend des documents, du protocole, des contraintes métier), mais il donne une indication : Mistral vise clairement le haut du panier.
L’argument décisif pour beaucoup d’organisations : l’auto hébergement
Le deuxième argument est souvent plus important que le premier : faire tourner OCR 4 sur ses propres serveurs.
Quand on parle de documents sensibles, “envoyer au cloud” n’est pas toujours une option.
- administrations
- services publics
- entreprises avec contraintes de confidentialité
- secteurs réglementés
Pour ces acteurs, la capacité à déployer en interne est un point qui peut faire basculer un achat, même si un concurrent est légèrement meilleur sur une métrique.
Un modèle compact, un déploiement simplifié
Mistral revendique un modèle compact, capable de tourner dans un seul conteneur, ce qui facilite la mise en production.
C’est un détail qui change tout pour les équipes techniques :
- déploiement plus simple
- dépendances réduites
- meilleure maîtrise de l’infrastructure
- intégration plus rapide dans une chaîne de traitement
Quand on traite des milliers ou des millions de pages, l’IA ne doit pas être une maquette fragile. Elle doit être un outil industriel.
Prix : 4 dollars les 1 000 pages, et moins en traitement par lots
Côté tarification, Mistral annonce :
- 4 dollars pour 1 000 pages
- 2 dollars pour 1 000 pages en mode batch
Le message est clair : OCR 4 vise des usages à grande échelle. Le mode batch est particulièrement intéressant pour les campagnes de numérisation d’archives, où l’on n’a pas besoin d’une réponse en temps réel.
Où utiliser OCR 4 : API et plateformes partenaires
OCR 4 est proposé via API et disponible sur plusieurs environnements cités :
- Mistral Studio
- Amazon SageMaker
- Microsoft Foundry
- bientôt Snowflake Parse Document
Pour les équipes produit et data, c’est un point clé : l’OCR est rarement un outil isolé. Il doit s’insérer dans une chaîne existante (ingestion, stockage, indexation, moteur de recherche, workflow de validation, export vers un SI).
Ce que ça change pour l’automatisation et les workflows documentaires
OCR 4 n’est pas juste une “IA qui lit”. Son intérêt apparaît quand on l’utilise comme première brique d’un pipeline.
De l’image au document structuré
Le vrai jackpot, ce n’est pas d’avoir du texte brut. C’est d’obtenir des données structurées :
- champs
- tables
- sections
- signatures détectées
- zones à vérifier
Quand la structure est reconnue, on peut ensuite :
- router automatiquement les documents
- déclencher des validations ciblées
- remplir des bases de données
- alimenter un moteur de recherche interne
- faire du classement documentaire sans y laisser sa santé mentale
Exemple simple : factures, bons, formulaires
Imaginez un traitement où :
1) OCR 4 extrait et structure
2) une règle vérifie les champs essentiels
3) les incertitudes passent en revue humaine
4) le reste est intégré automatiquement
Résultat : moins de saisie, moins d’erreurs, et plus de temps pour des tâches à valeur ajoutée. Oui, même dans un univers où le mot “tableau” provoque parfois une panique collective.
À surveiller : qualité réelle sur documents difficiles
Sur le papier, OCR 4 coche beaucoup de cases : structure, manuscrits, multilingue, auto hébergement, coût pensé pour le volume.
Le test décisif sera toujours le même :
- performance sur documents bruités
- tolérance aux scans médiocres
- gestion des mises en page exotiques
- robustesse sur les écritures manuscrites variées
Car entre un manuscrit lisible et une annotation griffonnée au coin d’un formulaire, il y a tout un monde. Et ce monde, c’est celui des organisations réelles.
Pourquoi OCR 4 peut devenir une pièce maîtresse de la numérisation en Europe
Avec OCR 4, Mistral avance un positionnement très européen : performance, multilingue, et surtout contrôle des données.
Si la promesse se vérifie en production, on pourrait voir accélérer des chantiers longtemps repoussés : archives, formulaires, dossiers, rapports, et tout ce qui encombre les armoires et les serveurs sous forme de PDF non exploitables.
Et si, au passage, ça réduit un peu le temps passé à chercher “où est passé ce fichu document”, ce sera déjà une petite révolution. Silencieuse, administrative, mais une révolution quand même.